Все новости
Ежедневный обзор

Главные новости ИИ и GPU за день

16 практических материалов об ИИ и GPU, опубликованных в нашем Telegram-канале 2026-10-05.

6 октября 2026

Главные новости ИИ и GPU за день
Искусственный интеллект1/16

ИИ объединил платежи — почему сумма уменьшилась?

ИИ объединил платежи — почему сумма уменьшилась?

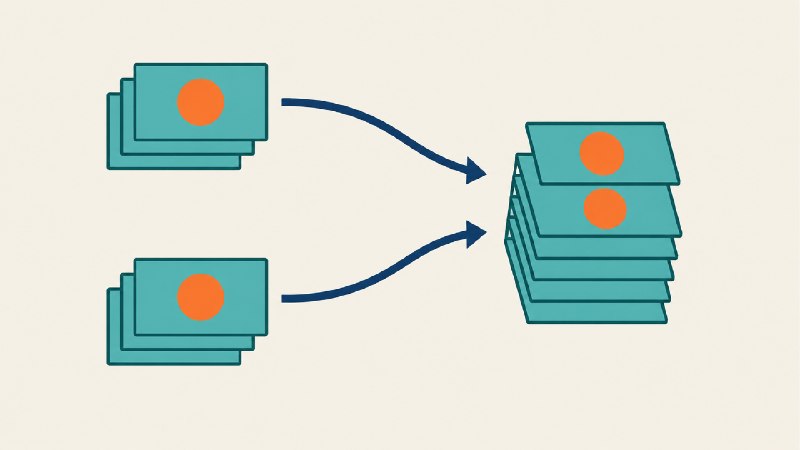
Факт: в SQLite UNION удаляет одинаковые строки результата, а UNION ALL сохраняет их. Если ИИ объединяет две выгрузки, выбирая только сумму, два разных платежа по 100 могут превратиться в одну строку. Это не ошибка сложения — запись исчезла раньше.

Как применить 1. Уточните задачу: сохранить все операции или получить уникальные значения? Для добавления строк одной выгрузки к другой без удаления повторов используйте UNION ALL. 2. Попросите ИИ проверить минимальный пример: SELECT 100 AS amount UNION SELECT 100; Вернётся одна строка. С UNION ALL — две; сумма их значений будет 200, а не 100. 3. До агрегации сохраняйте ID операции и источник. Сверьте число строк и итоговую сумму с исходными выгрузками.

Готовый prompt: Проверь мой SQLite SQL на потерю строк при объединении. Различай одинаковые значения и одну и ту же операцию. Покажи тест с двумя разными платежами одинаковой суммы, ожидаемые строки и итог. Не меняй правило удаления дублей без обоснования.

Ловушка: если выгрузки пересекаются и содержат одну операцию дважды, слепая замена на UNION ALL завысит итог. Удаляйте повторы по согласованному ключу операции, а не по совпадению суммы.

Сайт проекта: https://verum-ai.uz

GPU и инфраструктура2/16

GPU ждёт новую эпоху? Не перезапускайте workers зря

GPU ждёт новую эпоху? Не перезапускайте workers зря

Факт: в PyTorch DataLoader флаг persistent_workers=True сохраняет worker processes и их Dataset instances после полного прохода по данным. Default — False. Это позволяет не создавать workers заново на следующей эпохе, если используется тот же DataLoader.

Почему важно: если начало каждой эпохи тормозит из-за запуска workers, GPU может ждать данные. Более мощная карта не уберёт эту причину простоя.

Три шага: 1. Создайте DataLoader один раз, до цикла эпох. При num_workers > 0 сравните два отдельных запуска с persistent_workers=False и True. Не меняйте batch size, transforms и число workers. 2. Измерьте время от создания iterator до получения первого batch для первой и последующих эпох. Отдельно сравните полное время эпохи: более быстрый старт не гарантирует заметного ускорения всего training. 3. Проверьте host RAM между эпохами и корректность данных. Оставляйте True, только если выигрыш нужен, а сохраняемые workers и Dataset укладываются в память сервера.

Ловушка: пересоздание DataLoader внутри каждой эпохи уничтожает смысл настройки. Это не cache всего dataset и не экономия VRAM: worker state остаётся живым. Если меняете состояние Dataset по эпохам, отдельно проверьте, как обновление попадает в worker copies; обычное присваивание полю в главном процессе не является механизмом синхронизации.

Сайт проекта: https://verum-ai.uz

Искусственный интеллект3/16

Jina Reranker v3.5: top_n=3 не означает «обработать три»

Jina Reranker v3.5: top_n=3 не означает «обработать три»

Jina AI выпустила jina-reranker-v3.5 27 июля 2026 года. Это текстовый listwise reranker на 0.6B параметров: он сортирует кандидатов поиска, а не пишет ответ. Заявленный context — до 131K tokens; доступны веса, GGUF и MLX. Лицензия весов — CC BY-NC 4.0, не разрешение на коммерческое использование.

Практический факт: в опубликованном локальном методе rerank() параметр top_n применяется после вычисления scores и сортировки. Передали 100 документов с top_n=3 — модель не пропустит остальные 97. Уменьшение выдачи само по себе не сокращает основную GPU-работу.

Три шага: 1. Зафиксируйте baseline: один набор запросов, известные релевантные документы и 100 кандидатов из первого поиска. Замерьте качество первых трёх результатов, latency и пик VRAM при одинаковых dtype и GPU. 2. Чтобы снизить нагрузку, сравните с передачей только первых 30 кандидатов: model.rerank(query, documents[:30], top_n=3). Список должен быть заранее отсортирован первым поиском, не случайным порядком файлов. 3. Повторите замеры. Сокращайте вход только при допустимой потере качества: нужный документ может находиться за пределами первых 30. Ограничивайте также длину кандидатов, а не только их число.

Ловушка: 0.6B — не обещание фиксированного расхода VRAM при любом context. GPU выбирайте по фактической длине входа и параллельности. Для коммерческого внедрения отдельно согласуйте лицензию с Jina AI. Это совет по inference, не по training.

Сайт проекта: https://verum-ai.uz

Искусственный интеллект4/16

ИИ запросил 1000 записей — получил 100 и написал «всего»?

ИИ запросил 1000 записей — получил 100 и написал «всего»?

Факт: в GitHub REST API параметр per_page задаёт размер страницы, а не выгрузку целиком. По официальной документации, у большинства endpoints максимум — 100. Если запросить больше лимита, GitHub уменьшит значение без ошибки. Успешный HTTP-ответ не доказывает полноту отчёта.

Как применить 1. До сбора зафиксируйте endpoint, фильтры и период. Проверьте его лимит per_page; не пытайтесь заменить обход страниц значением per_page=1000. 2. После каждого успешного ответа сохраняйте записи и переходите по URL из заголовка Link с rel="next". Ссылки last может не быть — это не значит, что следующей страницы нет. 3. В итог внесите число полученных страниц, сырых записей и уникальных ID. Для обычного пагинируемого списка завершение — успешная последняя страница без next. При ошибке или rate limit пометьте выгрузку как частичную, а не «всего найдено».

Готовый prompt: Собери данные из этого GitHub REST endpoint: [URL]. Фильтры: [условия]. Обойди страницы по Link rel="next", сохраняй результаты каждой. Покажи число страниц, записей и уникальных ID, а также причину остановки. Не выдавай частичную выгрузку за полную; если запросы не выполнялись, скажи это.

Ловушка: обход всех страниц не создаёт snapshot: данные могут меняться во время сбора. Удаление повторов по ID не доказывает отсутствие пропусков. Для критичного отчёта нужна отдельная сверка за фиксированный период. Сайт проекта: https://verum-ai.uz

GPU и инфраструктура5/16

GPU ждёт, а CPU занят: проверьте число threads

GPU ждёт, а CPU занят: проверьте число threads

Факт: несколько PyTorch-процессов могут конкурировать за CPU, если каждый запускает слишком много threads. Это CPU oversubscription: переключения съедают время, а больше параллелизма не означает больше полезной работы.

Зачем: если CPU-часть pipeline не успевает готовить данные, покупка более мощной GPU не устранит эту причину простоя.

Что сделать: 1. Определите доступный задаче бюджет N vCPU и число одновременно работающих процессов M. Учитывайте лимиты контейнера, а не только весь сервер. Оставьте запас для DataLoader и других служб. 2. В каждом PyTorch-процессе до вычислений задайте torch.set_num_threads(T). Отправная точка из документации — T не выше целой части N/M; это бюджет, не обещание оптимальной скорости. Если процессов больше vCPU, сначала сократите их число. 3. Сравните исходный режим и меньшие T на тех же данных после прогрева: время batch целиком, throughput и ожидание GPU. Сохраните настройку только при измеренном выигрыше.

Ловушка: set_num_threads управляет CPU intra-op parallelism PyTorch, не CUDA threads и не всеми потоками tokenizer/других библиотек. Высокая загрузка CPU сама по себе не доказывает oversubscription.

Сайт проекта: https://verum-ai.uz

Искусственный интеллект6/16

Qwen3.5-0.8B: маленькая модель тоже может думать без конца

Qwen3.5-0.8B: маленькая модель тоже может думать без конца

Alibaba Qwen выпустила эту модель 02.03.2026 — не новинка дня. Веса открыты под Apache 2.0; вход — текст, изображения и видео, выход — текст. Заявленный context — 262 144 tokens. Здесь речь о post-trained версии, не Base.

Факт: разработчик предупреждает: в thinking mode именно 0.8B чаще других Qwen3.5 зацикливается в рассуждениях даже с рекомендованными sampling parameters. Маленькая модель не гарантирует короткий ответ или низкие затраты GPU-времени.

Три шага: 1. Для своей задачи сначала проверьте non-thinking — это default модели. Сохраните качество, число generated tokens и время до полного ответа. Не включайте thinking лишь потому, что он доступен. 2. Если reasoning нужен, включите его через параметры своего backend и сравните на тех же заданиях. Задайте лимит output tokens и времени запроса; используйте streaming, если он поддерживается, чтобы замечать повторения и отменять зависшие генерации. Сам streaming цикл не останавливает. 3. Перед выбором GPU измерьте peak VRAM и latency на рабочем context и batch. Убедитесь, что отмена действительно прекращает вычисление на сервере, а не только закрывает окно клиента. Если thinking не улучшает качество, оставьте non-thinking.

Ловушка: увеличение token budget может лишь продлить цикл. Официальная карточка ориентирует модель на прототипы и task-specific fine-tuning; универсального минимума VRAM не даёт. Лимит генерации не уменьшает память весов, а обрезанный ответ нельзя считать завершённым.

Сайт проекта: https://verum-ai.uz

Искусственный интеллект7/16

ИИ добавил .env в .gitignore — секрет уже защищён?

ИИ добавил .env в .gitignore — секрет уже защищён?

Факт: .gitignore не действует на файлы, которые Git уже отслеживает. Поэтому ответ coding-агента «добавил правило, теперь безопасно» недостаточен: файл с ключами может остаться в следующем commit.

Три шага перед commit: 1. Задайте точный путь к файлу с секретами. Для .env в корне репозитория выполните из корня: git ls-files -- .env Команда выводит путь, не содержимое. Если появилась строка .env, файл есть в index: одного ignore-правила недостаточно.

2. Проверьте только имена подготовленных файлов: git diff --cached --name-only Если там есть файл с секретами — остановите commit. Не просите ИИ вывести его содержимое «для проверки».

3. Согласуйте отдельно исключение файла из отслеживания. Если секрет уже был раскрыт, сначала отзовите или замените его; вопрос очистки истории решайте с командой, не автоматическим force push.

Готовый prompt: До commit проверь, отслеживается ли [путь], и покажи только имена staged-файлов. Секреты не читай и не выводи. При риске остановись. Не делай commit, push, удаление файлов или переписывание истории без отдельного разрешения.

Ловушка: пустой вывод первой команды не доказывает отсутствие секрета в других файлах или старых commits. .gitignore также не запрещает ИИ читать файл — доступ ограничивают отдельно.

Сайт проекта: https://verum-ai.uz

Искусственный интеллект8/16

DDP завис в конце эпохи? Сравните число batches

DDP завис в конце эпохи? Сравните число batches

Факт: при distributed training один rank может исчерпать данные раньше остальных. Другие процессы продолжат ждать парные collective operations. В PyTorch DDP есть join(), а режим throw_on_early_termination=True заставляет все ranks выдать ошибку, когда у одного закончатся данные.

Зачем: явная ошибка помогает не тратить GPU-время на ожидание и отличить несогласованный поток данных от проблемы сети.

Три шага: 1. Записывайте локально для каждого rank номер последнего batch и факт конца iterator. Сравните фактически обработанные batches, особенно после фильтрации записей. Не добавляйте для такого журнала новый all_reduce в цикл. 2. На коротком проверочном запуске оберните весь training loop на каждом rank в with ddp.join(throw_on_early_termination=True):, где ddp — ваша DDP-модель. Forward, backward и optimizer.step должны оставаться внутри. Сохраняйте исключение и завершайте проверку как неуспешную, а не подавляйте ошибку. 3. Если подтвердилось разное число шагов, проверьте sharding, sampler и локальные фильтры. После исправления повторите тест и сверку batches, прежде чем запускать долгий training.

Ловушка: обычный join() умеет продолжать работу при uneven inputs, но не знает о дополнительных collectives, например SyncBatchNorm или вашем all_reduce. При них документация требует throw_on_early_termination=True. Это fail-fast, не исправление данных и не лекарство от любого зависания.

Сайт проекта: https://verum-ai.uz

Искусственный интеллект9/16

Nemotron 3 Nano 4B: не всё внутри FP8

Nemotron 3 Nano 4B: не всё внутри FP8

NVIDIA выпустила модель 16.03.2026; это разбор, не новость дня. Текст → текст, context до 262K, открытые weights по NVIDIA Nemotron Open Model License. Доступны BF16, FP8 и GGUF Q4_K_M; основной заявленный язык — English.

Факт: официальный FP8 checkpoint использует selective quantization. Четыре Attention layers и четыре предшествующих им Mamba layers сохранены в BF16; Conv1D во всех Mamba layers — тоже BF16. Поэтому ярлык FP8 не означает, что каждый компонент занимает ровно вдвое меньше памяти, чем в BF16.

Как применить: 1. Выберите формат под engine и GPU: BF16 для baseline, официальный FP8 или GGUF Q4_K_M для отдельного сравнения. Не превращайте официальный FP8 checkpoint в «FP8 везде» собственным blanket cast. 2. На одинаковых prompts, context, batch и лимите ответа измерьте peak VRAM и latency после warm-up. Проверьте качество ответов и корректность tool arguments на своих задачах; держите thinking mode одинаковым. 3. Выбирайте GPU по пиковому расходу всего inference с запасом, а не по названию 4B/FP8. Учитывайте cache и runtime buffers. Универсальный минимум VRAM для любого workload в model card не указан.

Ловушка: NVIDIA сообщает о 100% median accuracy recovery FP8 на выбранных benchmarks. Это медиана конкретных тестов, не обещание равного качества каждого ответа. Для RU/UZ нужна собственная проверка; расходы fine-tuning этим inference-тестом не измеряются.

Сайт проекта: https://verum-ai.uz

Искусственный интеллект10/16

ИИ сделал «случайную» ссылку — её можно считать защищённой?

ИИ сделал «случайную» ссылку — её можно считать защищённой?

Факт: стандартный генератор Python random предназначен для моделирования, не для security tokens. Для ссылки сброса пароля просите secrets: внешне хаотичная строка ещё не означает криптографическую непредсказуемость.

Три шага: 1. Попросите ИИ найти место создания токена, а не только проверки его длины. Если там random.choice, замените именно генератор, не весь механизм восстановления.

2. Для URL-safe токена задайте количество случайных байтов явно: import secrets token = secrets.token_urlsafe(32) Здесь 32 — байты случайности, не длина строки. Не обрезайте результат ради короткой ссылки.

3. В тестовой среде проверьте жизненный цикл: действующий токен принимается, просроченный отклоняется, повторное использование после успешного сброса запрещено. Проверка «строки разные» не доказывает безопасность генератора.

Готовый prompt: Проверь генерацию password-reset token в этом Python-коде. Используй secrets.token_urlsafe(32), не random. Сохрани контракт API. Добавь и выполни тесты срока действия и одноразового использования. Покажи результаты без значений токенов; production не меняй.

Ограничение: secrets отвечает за случайность, а не за весь reset flow. Нужны безопасное хранение, срок действия и ограничение попыток. Не отправляйте реальные токены в чат с ИИ или логи.

Сайт проекта: https://verum-ai.uz

GPU и инфраструктура11/16

MIG: N/A в GPU-Util — не нулевая загрузка

MIG: N/A в GPU-Util — не нулевая загрузка

Факт: на A100/A30 в MIG mode NVML и nvidia-smi не поддерживают attribution метрик utilization к MIG devices. Поэтому N/A может отображаться даже при работающей CUDA-задаче. NVIDIA рекомендует DCGM для мониторинга MIG.

Почему важно: если dashboard заменяет «нет данных» на 0%, занятый раздел выглядит свободным. По такому графику нельзя решать, что сервер простаивает или GPU пора отключать.

Три шага: 1. Выполните nvidia-smi -L: сопоставьте GPU, MIG profile и UUID раздела с назначением вашей задачи. Это просмотр, не изменение конфигурации. 2. В сборщике метрик сохраняйте N/A как missing/null, не как ноль. Разделите alerts «низкая загрузка» и «телеметрия недоступна». 3. Для метрик MIG настройте совместимую версию NVIDIA DCGM. На короткой тестовой нагрузке проверьте, что меняется ряд именно нужного instance; сравните его с прогрессом приложения, например tokens/s.

Ограничение: конкретные метрики зависят от GPU, драйвера и версии DCGM. Здесь речь об A100/A30: не переносите ограничение автоматически на все поколения. Не отключайте MIG ради красивого процента в dashboard — это меняет распределение ресурсов.

Сайт проекта: https://verum-ai.uz

Искусственный интеллект12/16

Nemotron Parse v1.2: старый prompt работает — но хуже

Nemotron Parse v1.2: старый prompt работает — но хуже

NVIDIA выпустила эту OCR/VLM-модель 17.02.2026 — не новинка дня. Вход: изображение + prompt; выход: текст, классы и bounding boxes. Веса доступны по NVIDIA Nemotron Open Model License. Это парсер документов, не универсальный чат-бот.

Факт: в v1.2 обязателен четвёртый task token — извлекать ли текст внутри картинок. Старый prompt из v1.1 не вызывает ошибку: runtime его не проверяет, но NVIDIA предупреждает о значительном ухудшении качества. Поэтому «запрос прошёл» — плохой тест миграции.

Три шага: 1. Вместе с моделью обновите processor и task prompt по официальному примеру. Для пропуска текста внутри картинок: </s><s><predict_bbox><predict_classes><output_markdown><predict_no_text_in_pic> 2. Если важны надписи на вложенных фото или рисунках, замените последний token на <predict_text_in_pic>. Проверьте оба режима на одной странице с обычным текстом, таблицей и картинкой; сравните пропуски и порядок чтения с оригиналом. 3. Затем измерьте latency и peak VRAM: сначала batch=1, потом рабочий batch. Пропуск ненужного текста в картинках сокращает генерацию, но не размер весов. Официальный пример — CUDA/BF16; A100/H100 указаны как тестовое оборудование, не минимальная конфигурация.

Ограничение: общий context limit, минимальная VRAM и численные benchmark-результаты в этой model card не приведены. Не выбирайте GPU только по «менее 1B параметров» и не считайте отсутствие ошибки доказательством точного OCR.

Сайт проекта: https://verum-ai.uz

Искусственный интеллект13/16

ИИ ищет имя файла — а находит лишнее?

ИИ ищет имя файла — а находит лишнее?

Факт: в Python regex точка означает любой символ, кроме перевода строки по умолчанию. Поэтому re.fullmatch("invoice.pdf", name) принимает не только invoice.pdf, но и invoiceXpdf. Код работает без ошибки, а отбор уже неверный.

Три шага: 1. Уточните задачу: буквальное совпадение или regex? Для точного имени проще name == target, для буквальной подстроки — target in name. 2. Если regex действительно нужен, экранируйте вставляемый буквальный фрагмент через re.escape(target). Для совпадения всего имени: re.fullmatch(re.escape(target), name) is not None 3. Попросите ИИ выполнить тест: при target = invoice.pdf должны пройти invoice.pdf, но не invoiceXpdf и не invoice.pdf.bak. В локальном тесте Python этот вариант пропустил только первое имя.

Готовый prompt: Проверь поиск в этом Python-коде: пользователь задаёт буквальное имя, не regex. Предпочти обычное сравнение; если нужен regex, экранируй только буквальные фрагменты. Выполни позитивный тест и два похожих несовпадения. Покажи реальный вывод, файлы не меняй.

Ловушка: re.escape — для pattern, не для строки замены в re.sub. Экранирование всего составного regex превратит и задуманные операторы в обычные символы.

Сайт проекта: https://verum-ai.uz

GPU и инфраструктура14/16

CUDA Graph: почему все сохранённые ответы стали последним?

CUDA Graph: почему все сохранённые ответы стали последним?

Факт: при ручном использовании torch.cuda.CUDAGraph каждый replay перезаписывает тот же output tensor. Если после каждого batch делать results.append(y), список хранит ссылки, а не независимые результаты. В конце все они могут показывать последний ответ — без ошибки CUDA.

Зачем: ускорили inference, но незаметно испортили predictions для оценки качества. Сначала проверьте сохранность результатов, потом сравнивайте скорость GPU.

Три шага: 1. Найдите место, где сохраняется output захваченного graph. Нужен ли этот результат после следующего replay? 2. Если нужен, копируйте его вне capture, после replay и до следующего запуска: graph.replay() results.append(y.clone()) Здесь graph уже захвачен, y — его output, results — список. Вход обновляется перед replay. Этот фрагмент предполагает один CUDA stream для replay и clone. 3. Подайте два разных входа. Сравните сохранённые outputs с обычным eager inference на тех же входах и проверьте, что первый результат не изменился после второго replay.

Ловушка: clone расходует дополнительную VRAM и время копирования. Не копите outputs бесконечно; освобождайте их после обработки. Несколько streams требуют явных зависимостей — один clone не устраняет race condition.

Сайт проекта: https://verum-ai.uz

GPU и инфраструктура15/16

Kimi K2.5: две RTX 4090 — не весь сервер

Kimi K2.5: две RTX 4090 — не весь сервер

Kimi K2.5 от Moonshot AI — модель 2026 года, не новинка дня: текст, изображения и видео на входе, текст на выходе; context 256K, режимы Thinking/Instant. Веса доступны по Modified MIT; есть официальный API.

Факт: в deployment guide Moonshot результат LoRA SFT на двух RTX 4090 указан вместе с Intel 8488C, «1.97T RAM» и «200G swap». Это пример CPU+GPU-системы с KTransformers, а не обещание обучить модель на обычном ПК с двумя картами.

Почему важно: у этой MoE-модели 1T параметров всего, 32B активных. Небольшое число активных параметров не отменяет хранения остальных весов; экономия GPU не означает дешёвый сервер целиком.

Три шага перед закупкой: 1. Зафиксируйте версию stack и задачу: inference, LoRA SFT или full fine-tuning. Не переносите результаты одной задачи на другую. 2. Откройте руководство именно своей версии. У KTransformers 0.7.0.post4 проверенный пример текстового LoRA уже другой: 8× RTX 5090 для training, 4× для inference, два AMD EPYC 9355 и около 1.5 TiB RAM. Это референс, не универсальный минимум. 3. В смету внесите CPU, RAM, диски для весов и checkpoints, а не только VRAM. Сначала выполните короткий тест сохранения и resume по выбранному руководству, измеряя RAM, VRAM и время шага.

Ограничение: опубликованные 44.55 tokens/s относятся к конкретному старому SFT-примеру, не к вашему workload. Инструкции разных версий нельзя смешивать. Мы этот training не запускали; цифры — из документации.

Сайт проекта: https://verum-ai.uz

Искусственный интеллект16/16

ИИ проверил все записи — но записей не было?

ИИ проверил все записи — но записей не было?

Факт: в Python all([]) возвращает True. Поэтому код ИИ «все строки прошли проверку» может одобрить пустую выгрузку. Это не баг Python: отсутствие неуспешных проверок не доказывает наличие данных.

Три шага: 1. Задайте контракт: для этого отчёта нужна хотя бы одна запись. Пустая выгрузка — отдельный результат «нет данных», не «всё проверено». 2. Для готового списка булевых результатов проверяйте наличие элементов отдельно: ok = bool(checks) and all(checks) В отчёт выводите и число проверенных записей. 3. Попросите ИИ выполнить тесты. В нашем локальном запуске: [] → False, [True, True] → True, [True, False] → False.

Готовый prompt: Проверь этот Python-код валидации выгрузки. По контракту пустой набор не считается успешной проверкой. Отдели «нет данных» от «есть ошибки» и «всё прошло». Выполни тесты на пустой набор, все корректные записи и одну ошибочную. Покажи фактический вывод и число проверенных записей.

Ловушка: пример выше — для списка, не generator: даже пустой generator имеет bool(...) == True. Для потока учитывайте число реально прочитанных записей. Если пустой набор допустим по задаче, не запрещайте его автоматически.

Источник: https://docs.python.org/3/library/functions.html#all Сайт Verum AI: https://verum-ai.uz