Все новости
Ежедневный обзор

Главные новости ИИ и GPU за день

2 практических материалов об ИИ и GPU, опубликованных в нашем Telegram-канале 2026-10-08.

9 октября 2026

Главные новости ИИ и GPU за день
Искусственный интеллект1/2

Попросите ИИ найти цитаты до выводов

Попросите ИИ найти цитаты до выводов

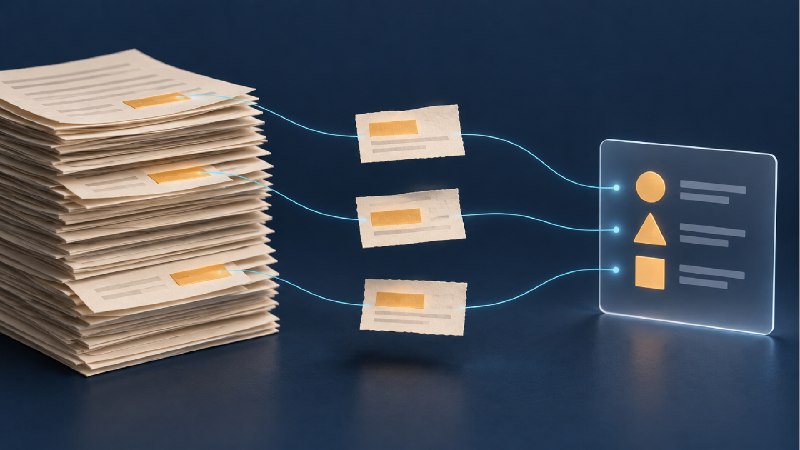
Вы загрузили длинный отчёт и получили гладкое резюме. Но откуда взялся вывод о задержке проекта? Попробуйте изменить порядок работы: сначала попросите ИИ показать нужные фрагменты, а уже затем объяснить их смысл.

В руководстве Anthropic для работы с длинными документами есть именно такой приём: попросить Claude сначала процитировать относящиеся к вопросу части. По объяснению разработчика, это помогает сосредоточиться на нужном содержании, а не на всём документе сразу.

Допустим, вы ищете причину переноса срока. Вместе с отчётом отправьте: Почему перенесли срок проекта? Сначала выпиши короткие точные цитаты из приложенного отчёта с названием раздела. Затем дай вывод и укажи, какой цитатой он подтверждён. Если причина не названа, напиши «в документе не указано». Не добавляй догадки.

После ответа откройте указанный раздел и прочтите соседние предложения. Цитата сама по себе не гарантирует верный вывод: важное условие могло остаться за её пределами.

Просите не просто ответ, а путь от фрагмента документа к выводу.

Искусственный интеллект2/2

Больше workers — не обязательно больше разных данных

Больше workers — не обязательно больше разных данных

Вы добавили процессы загрузки, чтобы GPU не ждала данные. Но перед замером скорости проверьте, не читает ли каждый процесс одно и то же. Для потокового dataset параллельная загрузка требует явного разделения работы.

В PyTorch у каждого worker своя копия IterableDataset — набора, который выдаёт примеры по очереди. Документация показывает: без разделения потока два workers возвращают одни и те же элементы повторно. Информация из get_worker_info() позволяет настроить отдельный участок для каждого процесса.

Начните с короткого конечного потока с уникальными ID. Прочитайте его целиком при num_workers=0, затем при num_workers=2 и сравните ID, а не только число batches. При повторах разделите поток в __iter__() или через worker_init_fn. Это предложенная проверка вашего загрузчика, а не отчёт о нашем тесте.

После исправления повторите проверку и только затем измеряйте скорость обучения. Совет относится к IterableDataset: не переносите его автоматически на обычный dataset с доступом по индексу.

Сначала убедитесь, что workers делят данные, а не дублируют их.