EmbeddingGemma 2: qisqa vektor — kichikroq model emas
EmbeddingGemma 2: qisqa vektor — kichikroq model emas
Hujjatlar bo‘yicha qidiruv juda ko‘p xotira egalladi va siz kattaroq GPU izlayapsiz. Avval model xotirasini qidiruv bazasi xotirasidan ajrating. Google DeepMind 2026-yil 6-oktabrda chiqargan EmbeddingGemma 2’da modelning o‘zini kichraytirmasdan, uning natijalarini ixchamlashtirish mumkin.
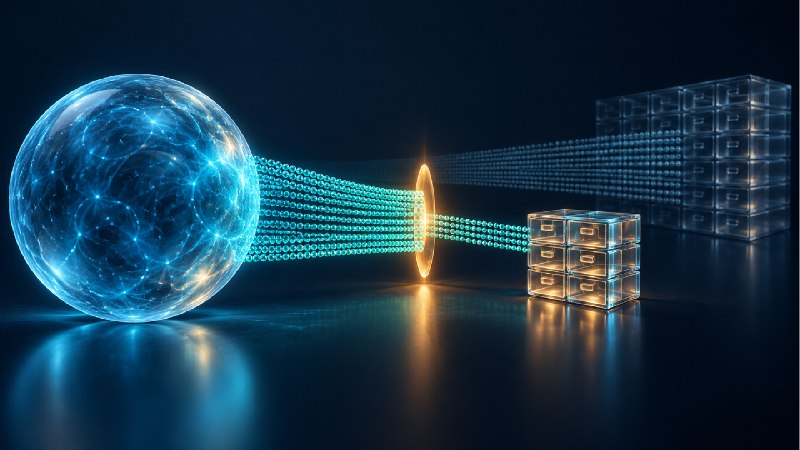
Bu embedding-model: u ma’lumotlarni ma’no jihatidan taqqoslash uchun vektorlarga — sonlar to‘plamiga aylantiradi. Google hujjatiga ko‘ra, Matryoshka Representation Learning yordamida 768 sonli natijani 256 songacha qisqartirish mumkin. Sonlar formati bir xil bo‘lsa, vektorlarning o‘zi uch baravar kam joy oladi. Butun baza ham shuncha kichrayishi kafolatlanmaydi: indeks va metama’lumotlar ham joy egallaydi.
Sinov indeksi uchun sentence-transformers’da model.encode chaqiruviga truncate_dim=256 va normalize_embeddings=True parametrlarini bering. Ikkinchisi qisqartirilgan vektorlarni qayta normallashtiradi. So‘rovlar va hujjatlar uchun bir xil o‘lchamdan foydalaning. Keyin o‘z savollaringiz bilan 768 va 256 o‘lchamda kerakli hujjatlar dastlabki natijalarga qanchalik tushishini solishtiring.
Aynan model vaznlari uchun VRAM yetishmasa, chiqish vektorini qisqartirish bu muammoni hal qilmaydi. Qisqa vektor natijalar uchun joy tejaydi, model vaznlarini kichraytirmaydi. Qidiruv sifati pasayishi mumkin: tejamkorlikni faqat fayl hajmi bilan emas, natijalar bilan ham tekshiring.