EmbeddingGemma 2: короче вектор — не меньше модель
EmbeddingGemma 2: короче вектор — не меньше модель
Ваш поиск по документам занял слишком много памяти, и вы присматриваете GPU побольше. Сначала разделите память модели и поисковой базы. У EmbeddingGemma 2 от Google DeepMind, вышедшей 6 октября 2026 года, можно уменьшить результаты работы, не уменьшая саму модель.
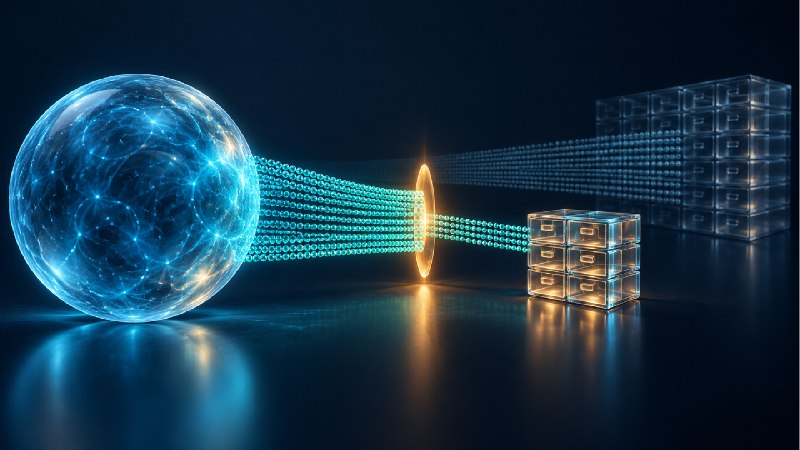
Это embedding-модель: она превращает данные в векторы — наборы чисел для сравнения по смыслу. По документации Google, её выход из 768 чисел можно сократить до 256 благодаря Matryoshka Representation Learning. При одинаковом формате чисел сами векторы займут втрое меньше места. Это не обещание втрое меньшей базы целиком: индекс и метаданные тоже занимают память.
Для пробного индекса в sentence-transformers задайте при model.encode параметры truncate_dim=256 и normalize_embeddings=True. Второй параметр повторно нормализует укороченные векторы. Используйте одну размерность и для запросов, и для документов. Затем на своих вопросах сравните, какие нужные документы попадают в первые результаты при 768 и 256 измерениях.
Если упираетесь именно в VRAM для весов модели, сокращение выходного вектора эту проблему не решает. Качество поиска может снизиться: экономию стоит проверять вместе с результатами, а не только с размером файлов.
Короткий вектор экономит место для результатов, а не уменьшает веса модели.